
Mit den so genannten Relationship tables (reltable) kann man die Beziehungen zwischen Topics definieren. Hiermit implementiert man Verlinkungen, die nicht durch die Hierarchie (oder die anderen collection-types) festgelegt ist. (mehr …)
Kategorie: Softwaredokumentation
-
Bedingter Text in der Praxis
Oder nennen wir ihn auch „conditional text“. Gemeint ist das Prinzip Texte mit einem Attributwert zu versehen und beim Generieren festzulegen, ob Elemente mit diesem Attribut inkludiert oder exkludiert werden.
Eigentlich eine feine Sache, um Produktvarianten zu handhaben (So geht es in XMetal).
Praxisbeispiel
Nun wende ich das ganze wirklich zum ersten Mal an und zwar hier:

Das Feature ist eigentlich dasselbe, nur dass es in Produkt A als „Copyright-Zeile“ auftaucht und automatisch ein ©-Zeichen eingefügt wird. Während in Produkt A1 das Feature „Fußzeile“ heißt und nichts automatisch eingefügt wird.
Dem Featurenamen hab ich daher in ph-Tags gepackt und sie entsprechend mit product_a oder product_a1 attributiert. Sieht eigentlich gut aus und am Ende kommt auch das raus, was ich will!
Haken an der Sache?
In obigemFall war das ganze einfach, weil die Features denselben Genus aufweisen und beide im Singular sind. Angenommen „die Fußzeile“ hieße eigentlich „der Fußmarker“ – da müsste ich beispielsweise Artikel oder Pronomina in den ph-Tag mitaufnehmen. Das obige Beispiel sähe dann so aus:

Irgendwie hab ich das noch unbegründete Gefühl, dass genau solche Fälle beim Übersetzen Ärger machen können, aber noch hab ich keine Beispiele dazu gefunden…
-
Links in DITA #2 – Hierarchien und collection-type
Ich habe bereits vorgestellt, welche Möglichkeiten des manuellen Verlinkens es gibt. Wie gesagt, erschwert diese Methodik die Wiederverwendung eines Texts. Da Wiederverwendung jedoch einer der Kernpunkte von DITA ist, gibt es natürlich auch hier Mittel und Wege. Und zwar indem man die Verlinkungregeln in die Maps auslagert. So kann man auch nur das verlinken, was in der Map drin ist und läuft nicht Gefahr tote Links zu erzeigen.
(mehr …) -
Spezialisierung: Eigene DITA-Attribute definieren
DITA bietet bereits einige Attribute, die schon sehr viele wichtige Dinge in der technischen Dokumentation abdecken: product, audience, platform seien da als Beispiele genannt.
Wenn es um sehr firmenspezifische Dinge geht, benötigt man hier schnell eigene Attribute. Für mich persönlich sehr wichtig, sind auch vorgegebene Attributwerte, weil eine vorgegebene Auswahl immer sehr viel weniger fehleranfällig ist.
Was bedeutet Spezialisierung?
In DITA nimmt man etwas Vorhandenes, also einen bereits vorhandenen Topictyp (z.B. Concept) oder ein bereits vorhandenes Attribut, und leitet davon seine eigene Version ab: man spezialisiert. Inbesondere in Bezug auf Topictypen ist wichtig zu wissen, dass man Festlegungen der DTD von der man ableitet, nicht „aufweichen“ kann. Wenn ein Element <hups> in der Ur-DTD zwingend erforderlich ist, kann man es in der Spezialisierungs-DTD nicht optional definieren.
Attribute spezialisieren
Es gibts 2 Arten von Attributen, die man spezialisieren kann: props (speziell für Filtern) und base (Sinn und Zweck hat sich mir noch nicht erschlossen…). Da ich mein neues Attribut zum Filtern des Contents benutzen möchte, benutze ich daher das props-Attribut.
Schritt 1: Attribut deklarieren
Ich werde nun ein Attribut definieren, das beschreiben soll, für welchen Hilfekontext das Element gilt: für die Hilfe im Web oder für die Hilfe in der Software.- Zuerst erstelle ich eine Datei namens helpContextPropsDomain.ent mit folgendem Inhalt:
Im ersten Teil lege ich den Namen des Attributs (help-context) fest und in meinem Fall auch 2 vordefinierte Werte (webpage, software). - Ich speichere die Datei im dtd-Verzeichnis des DITA-OT ab.
Schritt 2: Attribut der DTD bekannt machen
- Nun öffne ich die concept.dtd und lege noch eine Sicherheitskopie von ihr unter anderem Namen ab Man weiß nie… ;).
- Unter dem Bereich DOMAIN ATTRIBUTE DECLARATIONS füge ich ein:
 SYSTEM "helpContextPropsDomain.ent"

>

%help-context-props-d-dec; - Unter dem Bereich DOMAIN ATTRIBUTE EXTENSIONS erweitere ich :
- Unter dem Bereich DOMAINS ATTRIBUTE OVERRIDE erweitere ich :
&ui-d-att; &hi-d-att; &pr-d-att; &sw-d-att;

&ut-d-att; &indexing-d-att;&help-context-props-d-att;" > - Diese Schritte müssen nun für alle Topictypen wiederhiolt werden, für die man das Attribut braucht.
Schritt 3: testen 🙂
- Ich erstelle eine XML-Datei auf Grundlage dieser DTD
- Ich füge das Attribut _help-context=“webpage“_ in ein-Element ein
- Ich jage das Dokument durch einen Validator – und wenn der nicht meckert, hat es funktioniert
Spezialisierung in XMetal DITA Edition
Der XMetal DITA Edition bindet ein DITA-OT ein. Wie es scheint benutzt er dieses ausschließich zum Generieren.
Die DTDs, die XMetal benutzt, liegen im Programmverzeichnis unter „…XMetaL 5\Author\DITA\DITA_OT_DTD\“<.- D.h. die oben erstellten bzw. bearbeiteten Dateien müss dort hinein kopiert werden.
- XMetal neu starten
- Ein Concept anlegen
- Und sich freuen, dass man ein neues Attribut im Attribute Inspector sieht 🙂

Mehr zum Thema
In Eliot Kimbers Tutorial erfahrt ihr mehr zur Spezialisierung. - Zuerst erstelle ich eine Datei namens helpContextPropsDomain.ent mit folgendem Inhalt:
-
Links in DITA #1
Der Link ist essentieller Bestandteil der Online-Welt. Gerade bei der Topicorientierung, in der Information quasi auseinandergerissen ist, ist er die beste Navigationsmöglichkeit für den Leser und stellt einen Kontext her.
DITA ermöglicht einem einerseits manuell Links zu setzen oder sie automatisiert setzen zu lassen, indem man vorher den Beziehungsstatus definiert.
Heute gibt es erst einmal etwas zu den Links, die man als Redakteur selbst direkt einfügen kann.
<xref> – Inline-Links
Diese Links setze ich manuell mitten im Textfluss. Etwa so wie diesen hier. Dieses Vorgehen ist eigentlich allgemein bekannt.
Im Code sieht es so aus:
hier
Verlinken kann man alles von anderen Topics bis hin zu Webseiten (nur bei Links von generierten PDFs auf Online-PDFs muss man bei Verwendung des FOP aufpassen).
Generell ist das Verwenden von Inline-Links aber eigentlich nicht so toll:- sie unterbrechen des Lesefluss und die Aufmerksamkeit des Nutzers. Will man den Nutzer wirklich mitten im Task in einen völlig anderen Kontext schicken? Eigentlich nicht. Höchstens wenn es sich um eine Handlungsvoraussetzung handelt.
- ein Topic ist durch einen Inline-Link in der Regel schlechter wiederverwendbar. Verwendet man es wieder, könnte der Link kaputt gehen, weil das Linkziel in diesem neuen Kontext nicht vorhanden ist.
<related-links>
In der manuellen Variante der „Related links“ fügt man den Tag <related-links> ein und setzt die Links in einzelne <link>-Tags oder in eine <linklist>. Das Gute an diesem Tag ist, dass er am Ende des Topics gesetzt wird, also den Nutzer nicht aus dem Kontext reißt. Aber auch in dieser Option steckt der Nachteil, dass die Wiederverwendung des Topics eingeschränkt wird. -
IBM Task Modeler: die Anfänge einer Dokumentation
Ich bin in den letzten Monaten mehr land unter als mir lieb ist und man sieht doch eindeutig an der Zahl meiner Blogeinträge, dass ich nach Feierabend kaum noch Energie für TR abseits meiner Arbeit aufbringe. Dabei habe ich doch gerade in dieser arbeitsreichen Zeit wieder einigen Stoff gesammelt 🙂
Tasks konzipieren
jeder Schreiber kennt das: da sitzt man also vor dem leeren Blatt / dem weißen Screen und muss irgendwie anfangen mit der Doku. Ich fange in der Regel so an, dass ich mich erst einmal selber als Dummy durch das Produkt klicke und mir Tasks notiere, die ich dokumentieren würde. Von Mike Hughes habe ich mir abgeschaut, die größte Prio auf die Tasks zu setzen, da sie für den Nutzer erst einmal das Wichtigste sind, denn dieser will in erster Linie etwas MACHEN.Ideal für diese Vorgehensweise ist der IBM Task Modeler, ein eclipse-basierte Editor mit dem man Topics und ihre Beziehungen / Hierarchien in einer Map visualisieren kann. Man hat die Wahl zwischen einer Baumansicht und einer Listenhierarchie-Ansicht. Hier mal ein sehr einfaches Beispiel in einer Baumansicht:

Per Tastenkombination kann man sehr schnell Child-Topics ( Strg+Pfeil nach unten) oder Schwester-Topics einfügen und somit sehr zügig arbeiten. Man kann die Topics außerdem in der Anordnung per „Drag and Drop“ wild verändern, was meiner Arbeitsweise sehr entgegen kommt.
Ich sammele immer zuerst alle Informationen bzw. Topics und schiebe /lösche / erweitere /verteile dann so lange bis ich die perfekte Struktur finde. Gleichzeitig kann ich im Modeler auch schon alle Metadaten für die Topics bearbeiten oder die Reltables.
Tasks exportieren
Wenn ich nämlich all das fertig habe, kann ich ganz einfach hergehen und diese schöne Struktur mit allen Informationen exportieren: File > Export from Model > Stub Topic Files
Der Task Modeler generiert mir sogenannte Stub Files, d.h. Dateigerüste für jedes Topic. Diese Dateigerüste enthalten auch direkt alle Informationen, die ich eben eingegeben habe. Also für alle Tasks werden dann echte Task-Dateien mit den eingegebenen Titeln, Attributen etc. angelegt. Zusätzlich ich kann festlegen, dass in der exportierten Map auch automatisch die Referenzen auf die Stub Files gesetzt werden und die Dateinamen der Stub Files ihrem Topictyp entsprechen, d.h. dass beispielsweise alle Task-Dateien mit dem Präfix t_ im Ordner tasks abgespeichert werden. Und zack – hab ich die Grundlage zum weiteren Arbeiten.
Vorsicht ist allerdings speziell im Deutschen geboten, wenn man Umlaute im Titel verwendet, denn dieser ist auch Grundlage für die Dateibenennung und ID-Vergabe. Und der Task-Modeler schreibt diese Umlaute auch gnadenlos in den Dateinamen und in die ID: das Topic Lösung finden bekommt dann eben auch den Dateinamen t_lösung_finden.dita. Früher oder später führt so etwas immer zu Problemen, je nachdem wo die Dateien weiterverarbeitet werden. Mein Workaround war irgendwann, dass ich Umlaute in den Titeln einfach ausgelassen habe und sie später nach dem Export im Editor einfügte. Das ist schneller als alle Dateinamen und noch die ID zu bearbeiten.
Fazit – Task Modeler rockt!
Der Task Modeler ist eine super Unterstützung in der Konzeptionsphase einer DITA-basierten Dokumentation. Das Konzipieren ist schön einfach und am Ende kommt auch per Knopfdruck direkt eine schöne Arbeitsgrundlage raus, nämlich die Map plus Dateien.
Das Handling der Eclipse-Oberfläche ist allerdings für Nicht-Entwickler etwas gewöhnungsbedürftig – diese ganzen Panels sind einfach etwas verwirrend. Wärmstens zu empfehlen ist das Task Modeler Tutorial – diese Zeit sollte man sich nehmen, wenn man effektiv mit dem Tool arbeiten möchte.
Noch nicht getestet – Import von bestehenden Maps
Angeblich kann man andere Maps auch in den Modeler importieren, was sich natürlich für strukturelle Nacharbeiten sehr empfehlen würde. Allerdings habe ich das bisher noch nicht machen müssen 🙂
-
So geht’s… wahrscheinlich!
Ja, mein Sonntag ist heute teilweise von dem Papierhaufen auf meinem Schreibtisch geprägt, der mich seit einiger Zeit mahnend anwackelt. Und da die Steuererklärung hierzulande noch nicht auf den Bierdeckel passt, ist also Google mein Freund – und das ELSTER-Anwenderforum.
Naja, die Leute sind zumindest gewillt mir zu helfen, auch wenn sie selbst nicht immer genau zu wissen scheinen, wie man ihr Forum bedient:

-
Was soll ich schreiben?
Hey, als technischer Redakteur ist das doch eine einfache Frage: „Dokumentier halt, was man mit dem Produkt machen kann und was man nicht machen sollte.“ Soso…
„Dazu braucht man doch keine Hilfe!“
Ich habe gerade das erste Mal nach langer Zeit mal wieder ganz von Grund auf Hilfe zu einem neuen Produkt geschrieben. Und zwar für ein Produkt, das richtig schön zu bedienen ist. Bei dem man als Nutzer denkt: „Woohoo, wie konnten sie nur wissen, dass ich genau sowas will!?“
Tatsächlich erschließen sich die Basisfunktionen der Applikationen fast wie von selbst. Kurzum: es hat Spaß gemacht, dieses Arbeitsfeld zu erfassen. Daher hab ich auch oft gehört, dass ich doch dieses oder jenes nicht zu dokumentieren bräuchte, weil es doch wirklich selbsterklärend sei.
„Formatieren Sie Ihren Text fett.“
Ich fing also an alle Tasks zu erfassen, die man als Nutzer so machen kann. Sollte ich nun wirklich dokumentieren soll, wie man in einem Texteditor seinen Text fett oder kursiv formatiert? Mein Gott, das weiß doch JEDER. Hier fand ich die Bestärkung es doch zu tun:
[…] we have to cover every topic—yes, even niche topics—in fact, especially the niche topics. Perhaps only five users might ever read a particular topic, but if that’s the topic they need and we get them there fast, their customer satisfaction level shoots through the roof. (Mike Hughes)
[…] Help needs to be a mile wide—it must cover everything—and 30 seconds deep—tackling only small amounts of detail at any given point.
Wenn wir alles dokumentieren, heißt das auch, dass wir den Nutzer mit allem konfrontieren. Ich ganz persönlich finde es belustigend, aber auch ärgerlich, wenn mir jemand einen Text entgegenwirft mit einer Anleitung wie ich Text fett formatiere. Ich brauche das nicht, ich will das wirklich Wichtige wissen. Das heißt, man muss nach dem Schreiben noch den richtigen Weg finden, die Information zu strukturieren und anzubieten, und sei es nur eine wirklich gut funktionierende Suche (und DAS ist echt nicht selbstverständlich).
Nur noch 30 Sekunden
Ich glaube es wirklich, dass nach 30 Sekunden, wenn nicht soga weniger, der Nutzer genug hat. Aber manchmal ist das schwer in Einklang zu bringen, dass man dem Nutzer auch sinnvolle Information mitgeben will. Angenommen ich habe eine Konfigurationsseite und möchte dem Nutzer genug Entscheidungshilfen an die Hand geben; das wird einfach etwas länger werden, wenn ich nicht nur Handlungen nacherzähle. Das Dilemma, dass man als Nutzer Hilfe möchte, aber eben schnell, wird sich wohl nie wirklich auflösen.
Was soll wirklich drinstehen?
Oft genug findet man Anleitungen, in denen einfach nur die Oberfläche nacherzählt wird. Aber mal ehrlich, ein bisschen mehr Grips haben unsere Leser in der Regel schon. Warum erzählen wir Ihnen nicht einfach das, was sie wirklich nicht wissen können?
- Wie ich schon festgestellt habe, sollte man das absolut Offensichtliche weglassen, also den Nutzer eben nicht darauf hinweisen, dass er mit dem Speichern-Button doch tatsächlich seinen Text speichert!
- Das nicht Offensichtliche erwähnen, wie etwa, dass man ein Objekt zusätzlich auch über Drag&Drop bewegen kann und nicht nur über die Schieberegler.
- Man sollte nicht bloß nacherzählen WIE der Nutzer etwas machen kann, sondern WARUM er was machen könnt. Das heißt:
- Entscheidungshilfen geben:
„Wenn Sie Ihr Blog auch für Suchmaschinen sichtbar machen, kann es prinzipiell vom jedem gefunden werden. Bei einem privaten Blog sollten Sie Suchmaschinen besser blockieren.“ - sinnvolle Starthilfen / Beispiele geben:
„Zeigen Sie am besten maximal 5 Artikel pro Seite an, damit die Seiten nicht zu lang werden und damit unübersichtlich werden.“
- Entscheidungshilfen geben:
Fazit
Hey, wenn die Daseinsberechitgung eines Texts angezweifelt wird, werde ich ab sofort heroisch jedem Produktmanager, Conceptioner & Co. sagen: „Wenn ich auch nur einem Kunden damit weiterhelfen konnte, dann hat sich dieser Hilfetext gelohnt.“
Mein wichtigstes Fazit ist für mich den Nutzer nicht nur mit „Tu dies – klick das“ zu konfrontieren, sondern auch mit „Tu dies – das ist für jenes nämlich gut!“ Und dabei trotzdem im Blick zu behalten, diese Infos nicht zu überbordend zu gestalten.
-
Standardisieren ohne Kopf
Wenn man sehr viel schreibt, passiert es gut und gerne, dass man sich bestimmte Schreibmuster angewöhnt ohne darüber nachzudenken.
Sehr beliebt sind bei mir Füllwörter jeder Art, die ich bei meiner Master-Thesis am Ende per Strg+F suchen konnte, weil es zur der Zeit immer die dieselben zwei waren 😉 Ansonsten sind Schreibmuster für einen technischen Redakteur nicht das Schlechteste, da man schließlich standardisiert arbeiten soll. Aber in manchen Fällen denkt man vor lauter Standardisierung nicht mehr richtig nach.
Ich hab gestern bspw. ein kleines Review der Doku gemacht, an der ich gerade arbeite. Ich habe nach dem Muster „Klicken Sie auf XY, um das den Leuten ein X für ein U vorzumachen“ gearbeitet. Und zwar sehr streng. Zu streng. Zu kopflos.
Sätze wie „Klicken Sie auf Speichern, um zu speichern.“ erzeugen nur Textmüll und bringen keinen Mehrwert im Gegensatz zu „Klicken Sie auf Speichern.“. Vermeide das Offensichtliche, sag ich da nur!
-
DITA-Referenz in der Praxis: shortdesc vs context
Wenn man mit DITA anfängt, hat man zuerst das Gefühl: „Wow, ich muss nichts mehr selbst erfinden. Alles ist schon da! Woohooo!“ Kaum schreibt man ein bisschen länger, stellt man fest, dass es immer wieder Fälle gibt, in denen die DITA-Referenz nicht so eindeutig ist, wie man sich das wünscht
Ich habe mich beospielsweise immer schwer getan die Funktion der Tags shortdesc und context innerhalb eines Tasks zu trennen. Beide sind dazu da dem Nutzer zu sagen, was der Sinn und Zwecks des vorliegenden Topics ist. Bisher habe ich context nicht genutzt, aber so langsam komme ich dahinter, wie ich es nutze.
<shortdesc>
Die shortdesc soll das zentrale Ziel des Topics beschreiben, aber ganz kurz sein, damit man sie z.B. in Inhaltsverzeichnissen als Kurzbeschreibung mitliefern kann. Es macht aber auch nicht viel Sinn in der shortdesc einfach nur den Titel des Topics zu wiederholen, wie es in Hilfe nur allzu häufig passiert:
In diesen absolut selbst erklärenden Fällen lasse ich es auch weg, aber meistens versuche ich doch irgendwie, etwas reinzuschreiben. Auch in diesem Beispiel ist mir etwas eingefallen, was dem Nutzer in einer Kurzübersicht einen Mehrwert bringt und zwar indem es ihm schon einen Hinweis auf das Ziel gibt: „Links auf oft genutzte Webseiten speichern.“
<context>
Im context kann man mehr Informationen zum Topic geben. Und zwar wann und warum der Nutzer einen bestimmten Task ausführen kann / soll / muss. Gleichzeitig muss man hier ab auch aufpassen nicht so viele Hintergrundinformationen reinzupacken, dass man fast schon ein Concept draus machen könnte.
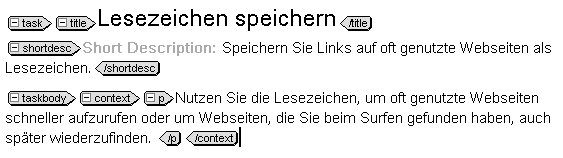
Je nach Fall ist das für mich auch der Ort nützliche Anwendungsbeispiele zu nennen.

