Kategorie: Erweiterter Horizont

  • Softwarelokalisierung und Kontext

    Ich habe bereits erwähnt, dass ein GUI-Texter/Übersetzer einfach nur eine Datei mit Text bekommt, im schlimmsten Fall eine ellenlange Datei mit Tausenden von Einträgen. Die Schwierigkeit hierbei ist nun, dass man gar nicht weiß wo der Text genau erscheint, in welchem Kontext er sich befindet, wenn man einfach nur die Datei vor sich hat. In manchen Fällen macht es das sehr schwer, überhaupt einen Text zu formulieren, der in diesem Kontext Sinn macht und man hat auch das Problem, dass man nie weiß, ob der Text in der GUI überhaupt genug Platz hat (z.B. „Publish“ versus „Veröffentlichen“: hier ist das deutsche Wort fast doppelt so lang).

    Beispiel für die Folgen von Kontextarmut

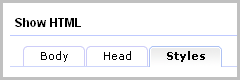
    Das Kontextproblem ist den meisten, die mit der Thematik kaum in Berührung kommen, nicht sofort verständlich. Für diese Fälle habe ich mein Lieblingsbeispiel aus der Praxis parat, das ich auch euch nicht vorenthalten möchte. Es führt klar und deutlich vor Augen, was fehlender Kontext bedeuten kann:

    Der Ausgangs-Dialog:
    html1

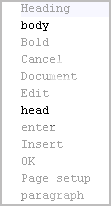
    Was der Übersetzer sehen konnte, war einfach nur Text  (vereinfachte Version):
    html_translator

    Was am Ende dabei rauskam:

    html2

    Die Moral von der Geschicht: Übersetzen geht ohne Kontext nicht!

    Wenn der Übersetzer des obigen Beispiels den Dialog vor sich gehabt hätte, wäre wohl kaum dieses Ergebnis rausgekommen. Es ist also dringend notwendig, dass ein Übersetzer den Kontext zu sehen bekommt.

    Wie bekommt der Übersetzer den Kontext?

    Das Allerbeste wäre eine Lokalisierungssoftware, die dem Übersetzer ein so genanntes „In-Place Editing“ erlaubt, d.h. der Übersetzer öffnet bspw. einen Dialog der zu übersetzenden Applikation und kann direkt an Ort und Stelle den Text ändern. Dabei stehen im in der Regel auch Translation Memories zur Verfügung. Gängige Namen für Lokalisierungssoftware sind hier „Passolo“ oder „VisuaLocalize“. Allerdings ist der Einsatz solcher Software bei den heutzutage hochdynamischen Web-Applikationen äußerst schwierig, da hier Seiten und Elemente zur Laufzeit generiert werden und eine ständige Verbindung zu anderen System haben müssen (deswegen bin ich auch gespannt auf den Vortrag „LOC13 Visual localization of web-based application“ auf der tekom-Tagung). Wenn man dann auch noch mehrere Applikationen übersetzen muss, die auch noch unterschiedliche Basistechnologien einsetzen, wird es richtig kompliziert.

    Eine andere gute Lösung für den Übersetzer ist eine Testversion der Software oder ein Testzugang der Webseite in der Quellsprache. Wenn das nicht möglich ist, dann sollte man zumindest Screenshots mitliefern. Und wenn das auch nicht praktikabel ist, muss ein Lektor her, der die übersetzten Texte in der GUI überprüft und bei Fehlern dann auch das Translation Memory aktualisiert.

  • Software-Lokalisierung für Technische Redakteure

    In der Softwarebranche kommen technische Redakteure früher oder später mit dem Thema „Oberflächentexte“ in Berührung. Ob sie sie schreiben oder nur verwalten dürfen, variiert von Firma zu Firma.

    Bei mir gehört das Betexten der Oberflächen zum Arbeitsalltag und hier möchte ich gerne mal berichten, wie sich das gestalten kann.

    Terminologiekontrolle, Hilfe und Beta-Test
    Ich sehe es als klaren Vorteil, dass ich die Produkte betexten darf. So kann ich nämlich von vorneherein für eine entsprechende Textqualität sorgen – mit dem richtigen Text in der Software entfällt oft so mancher Hilfetexte. Ich denke, jeder Redakteur musste schon die ein oder andere krude Formulierung von Entwicklern oder Produktmanagern umständlich in der Hilfe erklären…

    Für einen Redakteur ist das Betexten der Oberfläche also eine wunderbare Möglichkeit, um für Verständlichkeit und Terminologiekontrolle zu sorgen, aber sie eignet sich auch wunderbar zur Recherche für die späteren Hilfetexte. Dabei ist man dann gleich Beta-Tester, der schon weit vor der Qualitätssicherung die ersten Bugs findet. Ich finde das sehr spannend, weil ich gerne Applikationen neu entdecke und dabei der erste Usability-Tester bin 🙂

    Ein Feld, das sicher noch stärker von Redakteuren erobert werden muss 🙂

    Wie funktioniert Software-Lokalisierung?
    Nun aber mal zu den technischen Grundlagen: Glücklich kann man schon mal sein, wenn der Text überhaupt vom Code getrennt ist 😉 In der Regel machen das die meisten Software-Entwickler auch automatisch so. Erstens ist es für Entwickler übersichtlicher. Zweitens kann man so die Applikation leichter in verschiedenen Sprachen betreiben, was auch meistens gefordert ist.

    Gerade im Web-Bereich gibt es verschiedene Möglichkeiten zur Anwendungsbetextung.
    Gemeinsam ist den meisten, dass man man pro Sprache eine große Datei mit dem gesamten Anwendungstext hat. Für jede Stelle an der Text erscheinen soll, wird in der Software eine ID vergeben. Dieser ID ist dann in der Datei beliebiger Text zugeordnet: ein Wort oder sogar ganze Sätze.

    Nehmen wir als Beispiel mal WordPress, die Blog-Software, die ich hier benutze. Im Screenshot seht ihr den deutschen Text angezeigt:
    GUI_WP“

    Und hier seht ihr, wie das ganze in der Sprachdatei aussieht:

    #: wp-admin/edit-page-form.php:202
    msgid "pub_202"
    msgstr "<b>Sofort</b> publizieren"

    Die ID pub_202 wird in der Software als Platzhalter verwendet und je nach gewünschter Sprache wird der dazugehörige Text entweder aus einer deutschen oder bspw. englischen Sprachdatei gezogen. In der englischen Sprachdatei sieht der Eintrag so aus:

    #: wp-admin/edit-page-form.php:202
    msgid "pub_202"
    msgstr "Publish <b>immediately</b>"

    Bei einer Software wie WordPress kommt man auf stolze 3342 Texteinträge (Einträge, nicht Wörter!).

    Soviel zu dem Grundlegendsten. Wie solche Dateien nun editiert werden können, was es bei der Software-Lokalisierung zu beachten gilt und welche Felsen man wie umschiffen kann… das seht ihr in den bald folgenden Posts 🙂

  • User assistance mit DITA – Redakteuse live

    Es war etwas ruhig in den letzten Monaten. Das lag nicht zuletzt an einem äußerst spannenden Projekt mit DITA, das zwar genug Bloggenswertes ergab, aber auch dafür sorgte, dass ich gar nicht dazu kam zu bloggen bzw. auch mal nicht über DITA nachdenken wollte 🙂

    Nichtsdestotrotz will ich meine Erfahrungen zum Thema „User assistance mit DITA“ gerne weitergeben und praktischerweise ist mein Vortragsvorschlag dazu für die tekom-Jahrestagung 2010 angenommen worden 🙂

    Einen Vorgeschmack auf den Inhalt gebe ich euch schon hier und freue mich natürlich über jeden Zuhörer 🙂

    Die Herausforderung: eine kontext- und tarifabhängige Software-Hilfe, die den Kunden in seinen ersten Schritten begleitet. Dieser Vortrag stellt den Projektverlauf vor, in dem diese „embedded help“ entwickelt wurde. Der Bogen wird dabei von den wirtschaftlichen Beweggründen über die technische Umsetzung mit DITA bis hin zu den Lessons learned gespannt. Einen Schwerpunkt bilden dabei die Möglichkeiten, die man mit DITA out-of-the-box hat, und jene, die man erst selbst entwickeln muss.

  • tekom-Jahrestagung 2009 #2 – Dating DITA

    Ich war in sage und schreiben einem DITA-Vortrag. Erstens gab es davon gar nicht so viele („Der Hype flaut ab“, wie ein CMS-Hersteller mir bestätigte), zweitens waren die meisten davon eher auf einem Anfängerlevel.

    Bei diesem Vortrag war ich fast geneigt nicht hinzugehen, da mir der Titel zuerst zu gewollt witzig vorkam. Ein Blick in den Tagungsband hat mich dann doch überzeugt.

    Hier ging es um einen rein semantischen Blick auf DITA – was ich zur Abwechslung mal sehr erfrischend fand. Das ganze hier spielte hier keine Rolle:  „Dann kannst du auch noch das machen – und Maps und Conref… und DITAVAL… das Open Toolkit und Spezialisierung“

    DITA – die Informationsarchitektur

    Im Blickpunkt stand: die Sicht des Redakteurs. Kann man als Redakteur relativ einfach mit der DITA-DTD arbeiten? Erschließen sich bspw. Elementnamen sofort („Self-documenting structure“), braucht man am Ende keinen Styleguide mehr?

    Ralf Steiner und sein Team haben sich DITA angeschaut und ihnen ist Folgendes aufgefallen

    • endlos viele Titles (searchtitle, navtitle, title) und keine gute Abgrenzung
    • Abgrenzung zwischen abstract und shortdesc unklar
    • das Schachteln von versch. Topictypen ist fragwürdig.
      Ich finde es schon fragwürdig, zwei tasks ineinander zu schachteln.
    • Unterschied zwischen choices und choicetable ist unklar.
      Für mich ist das eine Layoutsache, manchmal lassen sich Handlungsvarianten besser tabellarisch darstellen. Aber natürlich ist das wieder so eine Sache, weil man ja hier semantisch denken sollte und nicht layoutorientiert. Doch zu 100% lässt sich das nie trennen, wie ich festgestellt habe.
    • Was soll das info-Element, wo doch ein Task keine Hintergrundinfo geben soll?
      Nun ja, ganz ohne Hintergrundinfo geht es eben nicht. Ich platziere hier auch nur Hintergrundinfo, die sich auf den spezifischen Schritt bezieht, daher hab ich an dem Element nichts auszusetzen.
    • Wozu braucht man steps-unordered?
      Ja, allerdings, wozu? Ob die Steps später nummeriert werden oder als Bullets dargestelt werden, entscheidet sich doch erst beim Generieren.
    • Die Concept-Topics sind eine Glaskugel aus der man alles ableiten kann.
      Oh ja! Ich habe bis heute nur eine vage Idee, wie ich Concepts wirklich standardisieren soll.
    • Die Benennung der Element ist inkonsistent bzw. nicht sprechend. Man könnte eine dl auch deflist nennen, äquvalent zur linklist.

    Ich füge noch hinzu:

    • Abgrenzung zwischen context und shortdesc ist schwammig.
    • Wozu werden related-links ermöglicht, wenn man doch nur die Wiederverwendung damit erschwert und Relationship tables eigentlich viel besser sind?
    • Für Tasten gibt es kein Element! Wie soll den Software-Dokumentation ohne Tasten gehen? Ich habe uicontrol daher eben auch hierfür als Auszeichnungselement definiert.
    • Ich kann das p überall benutzen, aber sollte ich auch? Zum Beispiel innerhalb von note, li, shortdesc, context etc.

    DITA – ohne Styleguide? Lieber nicht…

    Das ist das Fazit von Ralf. Und da kann ich mich voll und ganz anschließen. Ich habe auch zuerst ein Funktionsdesign erarbeitet und dann quasi mit DITA verheiratet. Es sind einfach zu viele Elemente, die nicht eindeutig out-of-the-box zu befüllen sind. Und man hat ja auch bei der Strukturierung immer noch sehr viele Freiheiten, die am Ende dann auch nicht mehr wirklich Standardisierung bedeuten.

    Insgesamt ein sehr guter und gut gehaltener Vortrag, der sich mal dem gewidmet hat, auf das es am Ende ankommt: kann man gut damit arbeiten?

    PS: Zu viele Bilder der personifizierten DITA sind dann irgendwann auch nicht mehr witzig…

  • tekom-Dokupreis 2009 im Visier

    Der diesjährige Dokupreis ging an einen Waffenhersteller.

    Das ganze hat ein wenig Wirbel ausgelöst – einerseits bei Friedensaktivisten, andererseits wurde die Frage aufgeworfen, ob hier alles korrekt abgelaufen ist.

    Zu letzterem: ich kann es mir nicht wirklich vorstellen, dass hier quasi Bestechung stattgefunden haben soll, aber das ist auch schon alles, was ich dazu sagen kann. Mir kommt es so vor, als ob der Hersteller sich einfach noch einmal rückversichern wollte, dass die Anleitung auch wirklich toll ist, bevor sie eingereicht wird. Und das wäre echt etwas affig…

    Mich stört eher der Aspekt, dass eine Waffenanleitung gewonnen hat. Mein erster Gedanke bei der Nachricht, war einfach: „Spinnen die total?“. Auch Prof. Schwermer – ehemals Jurymitglied- hat diese Anleitung wohl verstimmt:

    Im März 2009 verlässt Schwermer die Jury, weil er es verwerflich findet, an der Prämierung von Waffenanleitungen mitzuwirken. (Quelle)

    Ich habe TR-Fremde aus meinem privaten Umfeld dazu befragt und habe u.a. gehört: „Na, bei Waffen ist doch eine gute Anleitung gerade wichtig.“ / „Das ist auch Teil der Wirtschaft.“

    Nach meiner ersten Reaktion hab ich mir auch einige Fragen gestellt:

    • Darf man so eine Firma von vorneherein aus so einem Wettbewerb ausschließen?
    • Fängt da nicht schon eine Art ungerechte Selektion statt?
    • Muss nicht einfach das TR-Handwerk bewertet werden, unabhängig ob es eine Saftpresse oder eine Waffe ist?
    • Und wenn wir mit der Moral als Instanz beginnen – wer definiert die Grenzen dazu?

    Der Versuch diese Fragen zu beantworten, erklärt mir schon warum diese Anleitung nicht „rausgeworfen“ wurde. Objektiv und fair betrachtet spricht nichts dagegen diese Industrie in so einem Wettbewerb zuzulassen. Alleine: mir bleibt trotzdem ein schaler Nachgeschmack, wenn ich daran denke.

    Ich jedenfalls könnte es nicht mit mir vereinbaren hier an einer Bewertung mitzuwirken. Und eigentlich wünsche ich mir – so ganz persönlich-, dass das auch anderen so ginge.

  • tekom 2009 #1 – Erste Eindrücke

    So, nach einem Tag voller Eindrücke schaffe ich es sogar noch schnell einige davon zu bloggen 🙂

    • Alles neu angeordnet. Die Messe ist plötzlich unten, der Kaffeestand versteckt in der Messe statt in der Nähe der Vortragsräume (was ich sehr doof finde, denn das war der perfekte Ort zum Socializing nach den Vorträgen). Der Mensch ist ein Gewohnheitstier….
    • Tolle Veranstaltungstitel, die dann mit dem Vortragsinhalt nicht viel zu tun haben. Das nervt!!!!
    • Vortragsflüchtling, der: selten erlebt, dass so viele Leute Vorträge mittendrin verlassen. War das nur bei mir so?
    • Alte Bekannte treffen ist immer wieder schön 🙂

    Ich fürchte, ich hatte heute eher Pech mit meiner Vortragsauswahl. Mich hat nichts so recht vom Hocker gerissen – neue Denkanstöße hab ich nicht erhalten. Man kann das wohl am besten beschreiben mit: nichts Neues zu erzählen. Das war mein heutiger Haupteindruck. Und ich hoffe sehr, morgen wird das dann besser. Letztes Jahr war es da sehr viel inspirierender!

    Ausführlicheres folgt nach dem Tagungsstress 🙂

  • Firefox & seine html.css

    Ich bin gerade dabei meine DITA-HTML-Hilfe zu stylen. Da es lediglich um Aufhübschen ohne große Effekte geht, reaktiviere ich also meine HTML & CSS-Fähigkeiten.

    Eben hat mich aber eine Sache zum Wahnsinn gebracht, von der ich echt überrascht bin, dass ich sie noch nie bemerkt habe. Denn ich habe schon durchaus einige Zeit beim Webseiten-Bauen verbracht und das eigentlich immer nur unter Firefox.

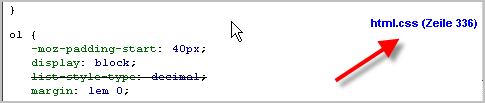
    In meinem Firebug hieß es bei einigen Elementen plötzlich, dass sie ihre CSS-Styles aus einer „html.css“ beziehen würden. Nun hieß meine eingebundene CSS-Datei aber anders! Ich hatte eine solche Datei nie erstellt und auch nie eingebunden! Argh!

    Nun diese Datei repräsentiert anscheinend die Default-Einstellungen des Browsers, d.h. solche Dinge wie Überschriften werden standardmäßig gestylt, was ja auch sehr nützlich sein kann, wenn eine HTML-Seite mal gar nicht „extra“ gestylt ist. Aber irgendwie ist mir in Firebug diese Datei noch nie aufgefallen…

    Extrem hilfreich zu wissen, wenn man mal wieder Webdesign betreibt. Wer mehr wissen möchte, möge bitte hierlang gehen: Undoing html.css

    PS: Ich habe bestimmt noch nicht das tolle Firefox-Addon IETab empfohlen. Damit kann man den Internet Explorer im Firefox verwenden, was absolut genial ist 🙂

  • tekom-Tagung 2009

    Gerade kam ein Newsletter hereinspaziert und berichtete mir vom Programm der tekom-Tagung 2009.

    Beim Überfliegen des Programms hat sich erst einmal ein positiver Eindruck eingestellt. Mir kam es vor, als ob nun verstärkt auf „Experten / Fortgeschrittenen“-Vorträge gesetzt wird. Letztes Jahr war das meiner Meinung nach noch nicht so. Interessant fand ich auch, dass auch ein Themenkomplex „Karriere & Persönlichkeitsentwicklung“ dabei ist, bei dem der Fokus teilweise gar nicht so stark auf der TR liegt, aber doch sicherlich hilfreich sein kann.  Wer gerade darum kämpft, ein CMS einführen zu wollen, tut sicherlich gut daran mal hier reinzuschauen: „Keine Chance? – Themen voranbringen und Projekte initiieren“ 😉

    Nun ja, mal sehen, ob ich dieses Jahr dabei sein kann. Dann werde ich natürlich wieder ausführlich berichten 🙂

  • Und es hat Bing gemacht!

    Mich hat der Hype um Microsofts neue Suchmaschine Bing relativ kalt gelassen, weil…naja, seien wir mal ehrlich… wann hat einen zuletzt was aus diesem Softwarehause schon groß umgeworfen?

    Nun mehren sich die Meldungen, dass der Marktanteil steigt und ich musste nun doch mal kurz reinschnuppern. (mehr …)

  • Schreib’s noch einmal, Sam!

    In Jacob Nielsens aktueller Kolumne kann man lesen, was für tolle Überschriften man doch auf BBC findet und wie super „web-usable“ diese doch sind.

    […] Web headlines, which must be:

    • short (because people don’t read muchonline);
    • rich in information scent, clearly summarizing the target article;
    • front-loaded with the most important keywords (because users often scan only the beginning of list items);
    • understandable out of context (because headlines often appear without articles, as in search engine results); and
    • predictable, so users know whether they’ll like the full article before they click (because people don’t return to sites that promise more than they deliver).

    Während ich diese Aufzählung lese, fühle ich mich sehr an mein Proseminar „Basiswissen Presse“ erinnert, indem genau das die Eckpfeiler der Aufgaben waren. Wir mussten regelmäßig Pressemitteilungen in einen Zeitungsartikel umzuwandeln, indem das Wichtigste in der Überschrift und im ersten Satz steht. Und nein, das war echt nicht so einfach und so manchen Artikel musste ich einige Male umschreiben, bis meine Dozentin es abnickte.

    Das ist klassisches Journalistenhandwerk und natürlich hat BBC das drauf. Wenn aber ein Web-Kenner wie Jacob Nielsen feststellen muss, dass genau das im Web das Herausragende ist, fühle ich mich einfach wieder bestätigt zu sagen: Nein, nicht JEDER kann schreiben.

    Die meisten Leute würden eher kaum auf die Idee kommen mal eben so einen Artikel für eine große Tageszeitung zu schreiben. Aber ein paar Sätze für die Webseite oder die Produktdokumentation sind dann natürlich „kein Problem“. Und die technische Redaktion darf dann ab und zu das Spiel „Rate, rate, wo kommt denn dieses Topic her?“ spielen 😉 Im Webbereich kann so eine Schreiberei dazu führen, dass der Leser nicht auf „Weiter“ klickt, folglich nichts kauft oder keine Werbeeinnahmen bringt und bei der Hilfe, dass der Leser nun doch den Support kontaktiert und damit weitere Kosten verursacht.

    Sooo einfach ist das alles also nicht. ein paar gute Gründe mehr dafür, warum nicht jeder technische Redaktion machen kann, hat Tom Johnson unlängst geliefert.

    Und Dilbert hat kurz davor das passende Bild abgeliefert (oh, ich wollte das noch ausdrucken und neben meinen Savage Chicken-cartoon hängen).
    Dilbert.com